Un sitio de varios cientos de páginas sin un sitemap XML es un problema concreto: contenidos recientes permanecen invisibles durante semanas porque los robots de exploración no los encuentran. Este caso se presenta en sitios de comercio electrónico, en blogs de publicación diaria o en portales institucionales cuya estructura supera cuatro niveles de profundidad.
El sitemap no lo resuelve todo, pero acelera el descubrimiento de las URL por parte de Google y Bing al proporcionarles una lista estructurada de lo que existe en el sitio.
La etiqueta lastmod en un sitemap XML: una señal a menudo mal utilizada
La mayoría de los CMS completan automáticamente la etiqueta lastmod del sitemap con cada registro de página, incluso para un cambio cosmético. Google aclara que esta etiqueta solo es útil si refleja una actualización significativa del contenido principal, de los datos estructurados o de los enlaces internos. Modificar un pie de página o una mención de copyright no justifica actualizar la fecha.
Cuando la etiqueta lastmod envía fechas poco fiables, Googlebot termina ignorándola. Entonces se pierde el único mecanismo del sitemap que permite señalar una prioridad de recrawl. Para un sitio que actualiza sus fichas de productos (precio, disponibilidad, descripciones), es un recurso desperdiciado.
La buena práctica consiste en informar lastmod únicamente sobre cambios realmente observables: contenido editorial modificado, nueva imagen añadida, datos estructurados actualizados. Si no se puede garantizar la exactitud de la fecha, es mejor omitir la etiqueta que enviar señales falsas. Se puede verificar un ejemplo concreto consultando el sitemap del sitio Experts Marketing, que ilustra la estructura de un archivo XML con sus etiquetas de fecha.
Sitemap y presupuesto de rastreo: por qué el tamaño del archivo cuenta
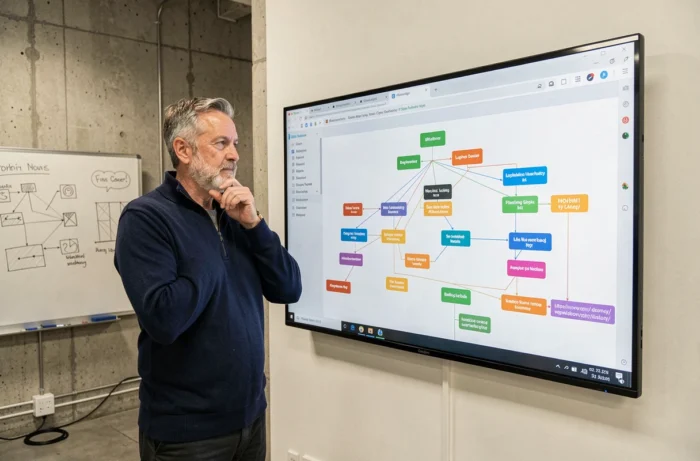
En un sitio de unas pocas decenas de páginas con un buen enlazado interno, el sitemap XML es casi superfluo. Google encontrará las URL siguiendo los enlaces. La situación cambia radicalmente para los sitios voluminosos o aquellos cuyas páginas están débilmente vinculadas.
El protocolo sitemap impone un límite de 50,000 URL por archivo y un peso máximo no comprimido enmarcado por el estándar. Más allá, se divide en varios archivos referenciados por un índice de sitemap. Esta división no es solo una formalidad técnica: un sitemap sobrecargado de URL obsoletas diluye la atención de los robots sobre las páginas que importan.
- Excluir del sitemap las URL redirigidas (301), las páginas en noindex y las URL canónicas hacia otras páginas. Su presencia genera errores en la Google Search Console y confunde el diagnóstico.
- Separar los tipos de contenido (artículos, fichas de productos, imágenes, videos) en archivos sitemap distintos para facilitar el seguimiento en Search Console.
- Regenerar el sitemap automáticamente con cada publicación o eliminación de contenido, en lugar de a intervalos fijos, para evitar el desfase entre el archivo y la realidad del sitio.
Las opiniones varían sobre el impacto directo del sitemap en el presupuesto de rastreo: Google considera el sitemap como una señal de descubrimiento, no como una directiva. Pero en catálogos de varios miles de referencias, un sitemap limpio sigue siendo el medio más fiable para señalar nuevas URL sin esperar a que se cree manualmente un enlace interno.
Presentación en Google Search Console: lo que realmente revela el informe del sitemap
Enviar un sitemap a través de Search Console no garantiza la indexación de las URL listadas. Este es un punto que muchos guías omiten. El sitemap es una señal de descubrimiento, no una instrucción de indexación. Google decide luego, página por página, si el contenido merece ser indexado.
El informe del sitemap en Search Console indica la fecha del último acceso por parte de Googlebot y el número de URL detectadas. Este diagnóstico permite identificar rápidamente un problema:
- Si el número de URL descubiertas es inferior al número de URL enviadas, algunas líneas del archivo contienen errores (URL bloqueadas por robots.txt, respuestas 404, redirecciones en bucle).
- Si Googlebot no ha accedido al sitemap en varias semanas, el archivo puede no ser accesible o el servidor está devolviendo un código de error intermitente.
- Si hay URL indexadas que no figuran en el sitemap, es que el archivo está incompleto o que la regeneración automática no funciona correctamente.
Se utiliza este informe como una herramienta de monitoreo, no como un panel de control del SEO global. Cruzando los datos del sitemap con el informe de cobertura de índice se obtiene una visión más completa del estado de exploración del sitio.
Sitemap XML o HTML: elegir según la necesidad real
El sitemap XML está dirigido a los robots. El sitemap HTML está dirigido a los visitantes. Ambos no tienen el mismo formato ni la misma utilidad, y la confusión entre los dos persiste.
Para el SEO, el archivo XML sigue siendo la prioridad. Estructura las URL con sus metadatos (fecha de modificación, frecuencia de cambio sugerida) en un formato legible por los motores de búsqueda. El sitemap HTML, por su parte, toma la forma de una página web clásica que lista las secciones del sitio con enlaces clicables.
Un sitemap HTML puede mejorar la navegación en un sitio cuya arquitectura es compleja, pero no reemplaza el archivo XML para el descubrimiento de contenido por parte de los motores. En un sitio bien estructurado con un buen enlazado interno, el sitemap HTML no aporta mucho. En un sitio institucional con decenas de subsecciones poco relacionadas entre sí, ayuda a los visitantes a encontrar una página sin pasar por la búsqueda interna.
La elección depende del perfil del sitio. Un blog de menos de cincuenta artículos con una navegación clara puede conformarse con el XML nativo generado por su CMS. Un sitio de comercio electrónico con categorías profundas y filtros facetados necesita un sitemap XML segmentado y, eventualmente, un plan de sitio HTML para sus usuarios.
El sitemap sigue siendo un archivo técnico entre otros recursos de optimización. Su verdadero aporte se mide en Search Console, observando la cobertura de índice y la velocidad de descubrimiento de nuevas páginas. Un archivo limpio, actualizado, depurado de URL innecesarias, ahorra tiempo a los robots y a quienes diagnostican problemas de indexación.